
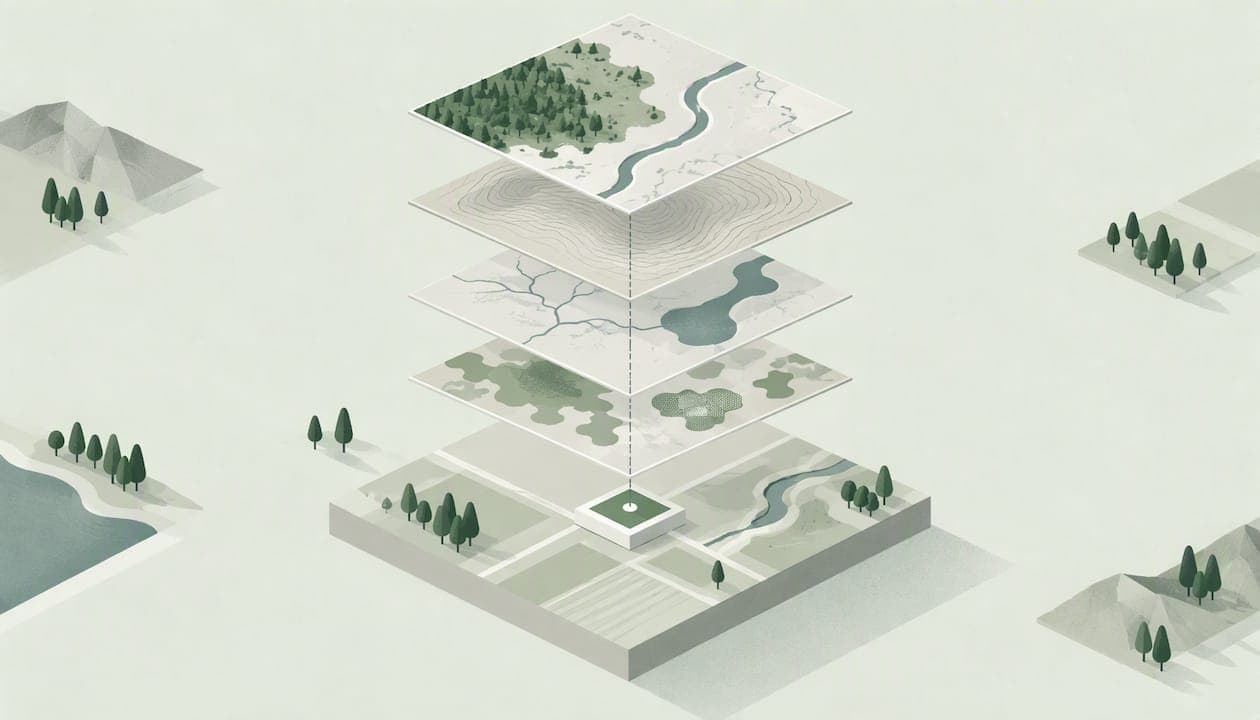
Croiser des données environnementales consiste à rapprocher, pour un même site, plusieurs bases publiques (eau, sol, biodiversité, aléas climatiques, zones protégées) afin de combler les lacunes de chacune et d'obtenir une lecture fiable de l'exposition réelle. Pour un établissement financier, l'enjeu est précis : passer d'un score sectoriel ou national à une évaluation par actif, documentée et défendable en comité de crédit. Cet article détaille la démarche, les sources françaises mobilisables, les points de contrôle qualité et la manière de restituer le résultat.
En bref
- Le croisement combine plusieurs bases pour compenser leurs lacunes temporelles ou spatiales, puis valide les résultats par des observations de terrain lorsqu'elles existent.
- La qualité de la géolocalisation des sites conditionne tout le reste : une adresse mal positionnée produit un score faux, même avec d'excellentes données.
- En France, data.gouv.fr, ecologie.data.gouv.fr et cartes.gouv.fr constituent les points d'entrée publics, avec des données de qualité hétérogène.
- Le résultat doit être traçable : sources, dates, hypothèses et limites sont consignés pour que la décision de crédit soit défendable.
Table des matières
- Ce que recouvre le croisement de données environnementales
- Les sources de données environnementales françaises
- Géolocaliser les sites avant tout croisement
- Harmoniser des données de résolutions et de dates différentes
- Les limites des modèles et de l'apprentissage automatique
- Interpréter le résultat : exposition, sensibilité, vulnérabilité
- Documenter pour la décision de crédit
- Le point de vue de Greenance
- Automatiser le croisement dans le processus crédit
- Erreurs fréquentes à éviter
- Questions fréquentes
- Sources
Ce que recouvre le croisement de données environnementales
Une donnée environnementale isolée décrit un phénomène, rarement un risque. Une carte d'inondation indique un aléa, une couche de zones protégées signale une sensibilité écologique, une donnée de stress hydrique renseigne une pression sur la ressource. Le risque d'un site naît de la combinaison de ces couches avec ses caractéristiques propres : localisation précise, activité, dépendance à l'eau, proximité d'écosystèmes sensibles.
Le NGFS décrit cette logique dans sa note d'avril 2026 sur les données liées à la nature : combiner plusieurs bases pour pallier leurs lacunes temporelles ou spatiales, mobiliser des données granulaires, et calibrer ou valider les modèles biophysiques à l'aide d'observations de terrain. La même note précise que les risques liés à la nature doivent être abordés aux niveaux individuel et systémique, en évaluant l'étendue et la nature des dépendances et des impacts des entreprises sur les écosystèmes.
Trois niveaux de lecture se distinguent :
| Niveau | Question posée | Exemple de donnée |
|---|---|---|
| Aléa | Quel phénomène touche la zone ? | Inondation, sécheresse, retrait-gonflement des argiles |
| Sensibilité du milieu | Quel écosystème ou quelle ressource est concerné ? | Zones protégées, bassins en tension, qualité des sols |
| Vulnérabilité du site | Que subit réellement l'actif, compte tenu de son activité ? | Dépendance à l'eau, emprise, sites pollués à proximité |
C'est le passage du premier au troisième niveau qui fait la valeur d'un croisement : il transforme des cartes en information de décision.
Les sources de données environnementales françaises
Le paysage français est riche mais éclaté. Quatre points d'entrée couvrent l'essentiel des besoins d'une analyse par site.
Les catalogues publics
data.gouv.fr est présenté dans les guides officiels comme le premier point d'entrée pour la recherche de données ouvertes, sur des thématiques allant de l'énergie à la santé et à l'environnement. Le catalogue d'ecologie.data.gouv.fr en est un sous-ensemble : il référence des jeux de données utiles aux politiques publiques du pôle ministériel, produits par l'administration centrale, les services déconcentrés, des opérateurs comme l'IGN, Météo-France et l'Ademe, mais aussi par des associations, des syndicats mixtes, des GIP et des entreprises comme EDF et Engie.
Pour la dimension cartographique, cartes.gouv.fr permet de rechercher des données publiques par thème (eau, environnement) et de filtrer par producteur, date ou territoire. Ce filtrage par date et par producteur est utile : il permet de vérifier la fraîcheur d'une couche avant de l'intégrer.
Les inventaires thématiques
L'Ineris a publié un inventaire des bases de données environnementales nationales, qui cite notamment Basias, Basol, Ades ou Geod'air. L'institut souligne que la qualité des données y est hétérogène et leur exploitation complexe, et que la cartographie à partir de données de terrain de natures très différentes suppose un traitement important. Cet avertissement vaut pour tout croisement : plus les sources sont nombreuses, plus la phase de préparation pèse.
La disponibilité selon le secteur
Tous les actifs ne sont pas égaux devant la donnée. Un rapport du CGFI de 2024 sur les sources de localisation d'actifs indique que la disponibilité varie considérablement : de bonnes données pour l'extraction minière et l'énergie, des lacunes importantes pour l'agriculture, la forêt et la pêche. Un portefeuille agricole demandera donc plus de recoupements et d'hypothèses explicites qu'un portefeuille énergétique.
Comment choisir une source
Quatre critères suffisent en pratique :
- Le producteur : une source institutionnelle ou un opérateur public est préférable pour une décision soumise à un contrôle.
- La date de mise à jour : une couche ancienne peut être valable pour une donnée structurelle (relief, hydrographie) mais pas pour une donnée évolutive (état d'une nappe, périmètre d'une zone protégée).
- La résolution spatiale : une maille communale ne dit rien du terrain d'un site industriel.
- La licence et la reproductibilité : une donnée ouverte garantit que l'analyse pourra être rejouée et auditée.
Géolocaliser les sites avant tout croisement
Le croisement n'a de sens que si chaque site est placé au bon endroit. Or les données d'entrée dont disposent les banques sont souvent une raison sociale, une adresse de siège ou une liste d'établissements sans coordonnées. Un siège social n'est pas un site de production, et un site de production n'est pas toujours l'adresse postale.
Un rapport de Natixis sur les données géospatiales relève que la précision de position est fiable pour les données GPS mais souvent médiocre pour des adresses géocodées manuellement, ce qui peut désaligner un site et une carte de risques. Quelques bonnes pratiques en découlent :
- distinguer le siège, les établissements et les sites opérationnels ;
- conserver la source de chaque coordonnée (GPS, géocodage d'adresse, repérage cartographique) ;
- associer à chaque site un niveau de confiance de localisation, repris ensuite dans la restitution ;
- contrôler visuellement les sites à fort enjeu sur fond cartographique.
Nous détaillons cette étape dans notre article sur la géolocalisation des sites d'entreprise pour évaluer le risque nature.
Harmoniser des données de résolutions et de dates différentes
Une fois les sites placés, les couches doivent être rendues comparables. Les inondations sont cartographiées à une échelle fine, les indicateurs de sécheresse à une échelle de bassin ou de maille climatique, les zones protégées en polygones, les pressions sur l'eau en données de stations. Les formats varient, les mises à jour aussi. Le CGFI parle d'un paradoxe de disponibilité : les données de localisation sont plus accessibles qu'on ne le croit, mais leur usage est freiné par des formats incohérents et une faible fréquence de mise à jour.
Le NGFS recommande une séquence claire : identifier d'abord les lacunes de données, puis appliquer des approches statistiques (sous-échantillonnage, pondération, imputation), et enfin valider les modèles biophysiques à l'aide d'observations de terrain ou de stations de suivi lorsqu'elles sont disponibles.
Concrètement, un protocole d'harmonisation robuste comprend :
- Un référentiel spatial commun : un même système de coordonnées pour toutes les couches.
- Une règle d'échelle : pour chaque couche, la distance ou le périmètre pertinent autour du site (le site lui-même, un bassin versant, un rayon).
- Une règle de date : la période de référence retenue, et le traitement des couches plus anciennes.
- Un traitement des valeurs manquantes : imputation documentée, ou mention explicite de l'absence de donnée plutôt qu'une valeur neutre.
- Un contrôle de cohérence : comparaison avec des observations locales ou des stations de mesure.
Les limites des modèles et de l'apprentissage automatique
La modélisation et l'apprentissage automatique accélèrent le traitement de volumes importants. La feuille de route données du ministère de la Transition écologique de 2021 souligne que l'usage des données pour la transition suppose des outils de modélisation et d'IA, compte tenu de la complexité écosystémique des enjeux. Le même document présente la gouvernance des données géographiques comme un levier majeur pour valoriser le patchwork de données nécessaires sur tous les territoires.
Le NGFS apporte la mise en garde complémentaire : l'apprentissage automatique est utile pour repérer des relations statistiques, mais il peut omettre des complexités physiques et produire des évaluations trompeuses, et une faible qualité de données risque de simplifier à l'excès les processus environnementaux. La conséquence pratique est simple : un modèle doit toujours être accompagné de sa méthodologie, de ses sources et d'un contrôle par des experts du domaine.

Interpréter le résultat : exposition, sensibilité, vulnérabilité
Un croisement produit d'abord un volume de valeurs, pas une conclusion. L'interprétation suit trois questions.
Le site est-il exposé ? On regarde la présence d'un aléa ou d'une pression sur la zone : risque d'inondation, tension sur l'eau, proximité d'un espace protégé.
Le site y est-il sensible ? Une usine de transformation agroalimentaire très consommatrice d'eau dans un bassin en tension n'a pas le même profil qu'un entrepôt logistique situé dans la même zone.
Que révèle l'ensemble du portefeuille ? La somme des sites expose des concentrations : plusieurs actifs d'un même emprunteur dans un même bassin, ou un secteur dont les sites sont systématiquement proches de zones sensibles. À l'échelle d'un portefeuille, c'est cette lecture agrégée qui oriente la priorisation. Notre article sur la priorisation des actifs à risque par site propose une démarche en cinq étapes pour les équipes crédit.
Un exemple documenté montre l'intérêt de ce changement d'échelle. Société Générale a analysé plus de 4 000 actifs physiques de production en croisant des données de production par type d'énergie et par pays avec les localisations des actifs, afin d'identifier les pressions sur la nature. Le principe est transposable : ce sont les localisations qui font parler les données sectorielles.

Documenter pour la décision de crédit
Une analyse n'est utile en comité que si elle est traçable. Le NGFS note que l'absence de cadres de reporting standardisés limite l'évaluation des risques financiers liés à la nature. En l'absence de standard unique, la défendabilité repose sur la documentation propre à l'établissement. Une fiche d'analyse par site gagne à contenir :
- l'identité du site et la méthode de géolocalisation, avec son niveau de confiance ;
- la liste des couches mobilisées, leur producteur et leur date ;
- les règles d'échelle et de traitement des lacunes ;
- le score ou la qualification obtenue, accompagnée d'une lecture qualitative ;
- les limites connues et les points à vérifier avec l'emprunteur ;
- la recommandation retenue (poursuite, conditions, approfondissement).
Pour voir à quoi ressemble une restitution de ce type, notre exemple de rapport risque nature pour un comité de crédit en présente la structure, et l'article sur le géocodage, le score et la décision en portefeuille décrit l'enchaînement complet.
Le point de vue de Greenance
Notre expérience du croisement de données environnementales tient en un constat : la difficulté n'est plus l'accès à la donnée, mais sa mise en forme à l'échelle du site et sa traduction en information exploitable par une équipe crédit. Les bases publiques existent en grand nombre. Ce qui manque aux équipes, c'est le temps de les rapprocher, de les harmoniser et de les documenter pour chaque actif.
C'est pourquoi nous avons conçu Greenance autour de trois principes. D'abord, partir du nom de la société pour géolocaliser les sites, afin que l'analyse porte sur des lieux réels et non sur des moyennes sectorielles. Ensuite, croiser des centaines de sources environnementales publiques (eau, sol, biodiversité, sécheresse, inondations, zones protégées) pour produire un score de vulnérabilité accompagné d'une interprétation qualitative lisible sans formation technique. Enfin, conserver la traçabilité des données et une méthodologie documentée, validée avec des professionnels du secteur bancaire, de façon à ce que chaque conclusion puisse être présentée et défendue.
Nous considérons que cette approche répond à la direction prise par les attentes réglementaires, qu'il s'agisse du cadre TNFD et de la démarche LEAP ou des attentes de la BCE et de l'EBA : une évaluation granulaire, reproductible et intégrée aux processus de crédit.
Balthazar
Automatiser le croisement dans le processus crédit
La démarche décrite ci-dessus peut être menée manuellement sur quelques dossiers. Elle devient difficile à tenir dès que le nombre de contreparties augmente ou que les analyses doivent être renouvelées régulièrement. Greenance est une plateforme SaaS qui automatise l'analyse du risque nature à l'échelle du site : géolocalisation à partir du nom de la société, croisement avec des centaines de bases publiques, score de vulnérabilité, interprétation qualitative, export PDF structuré et indicateurs GO/NO-GO pour le comité de crédit.
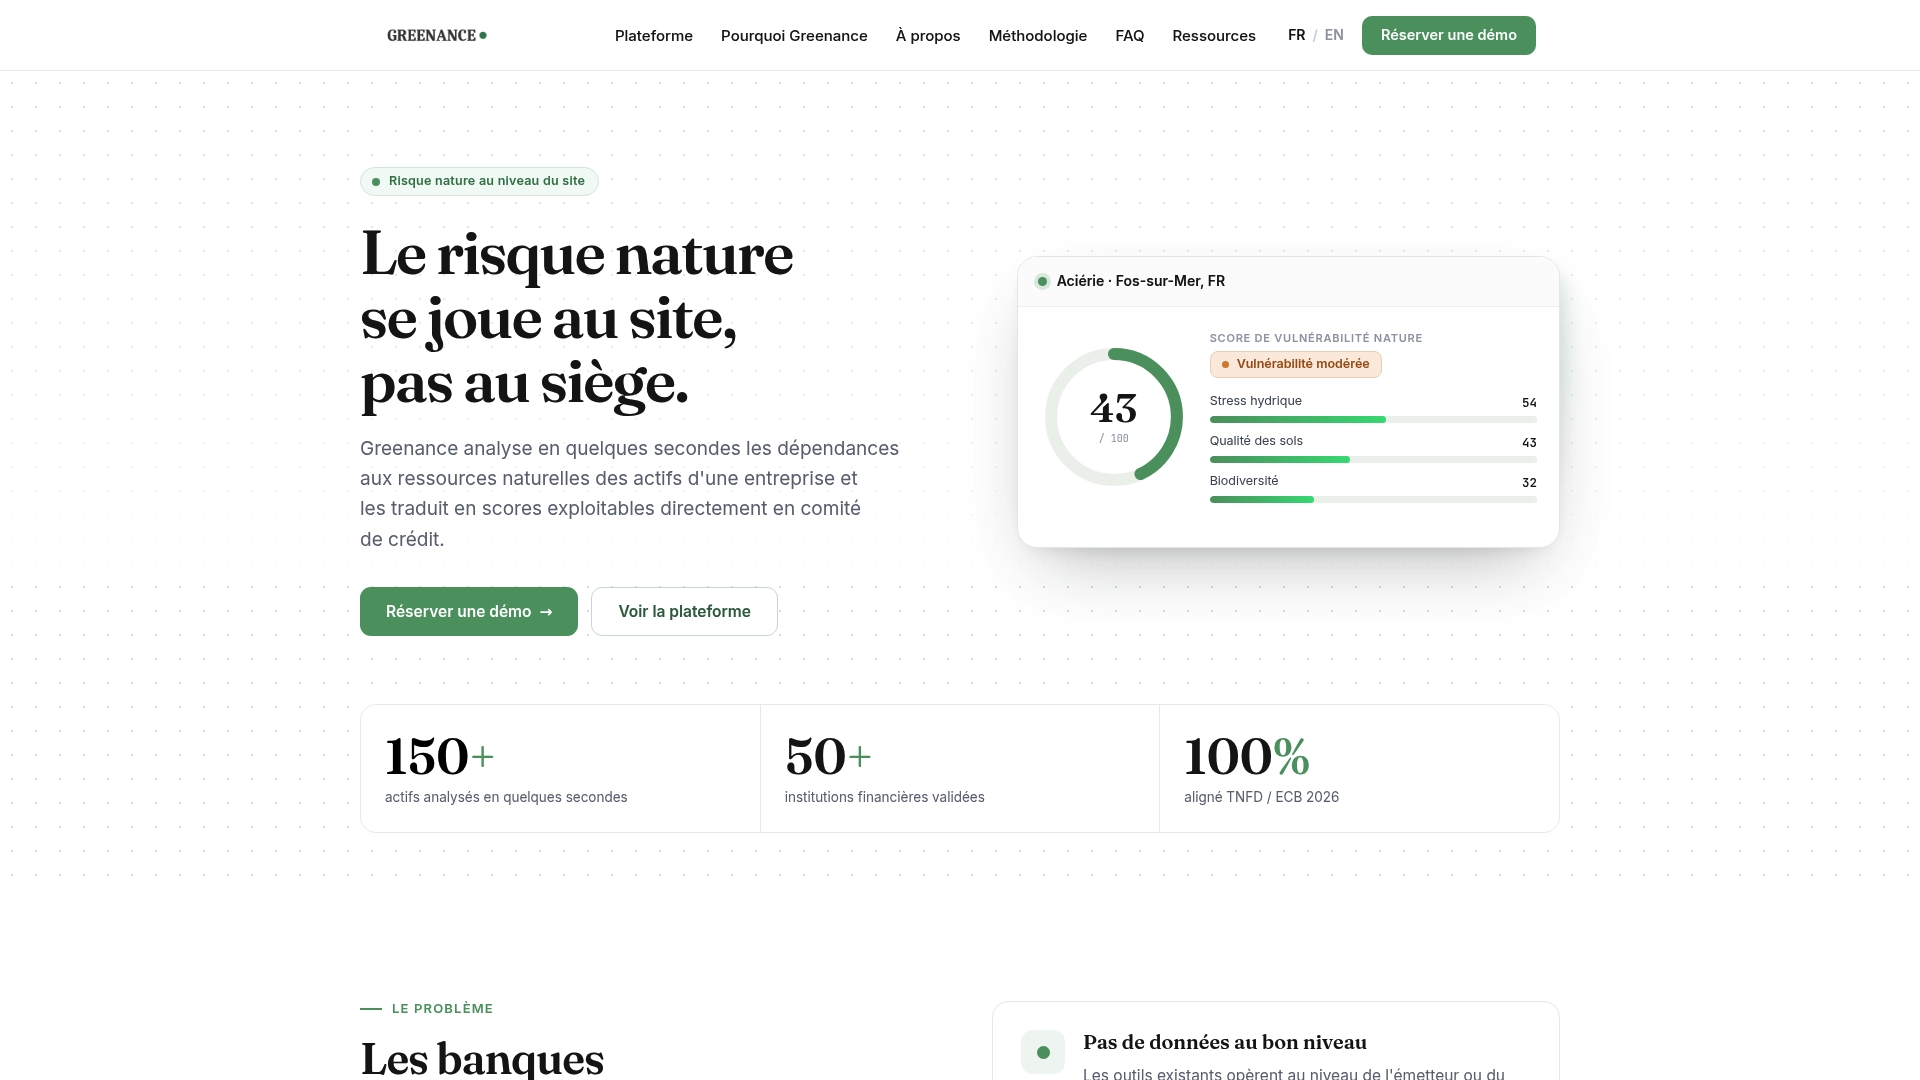
La plateforme s'adresse aux équipes crédit, risques et ESG des banques, gérants d'actifs, assureurs crédit et banques de développement, ainsi qu'aux cabinets de conseil. Le détail de la méthodologie du risque nature est publié sur notre site, et nos ressources rassemblent les analyses complémentaires. Une démonstration permet de tester l'outil sur vos propres contreparties depuis la page d'accueil.
Erreurs fréquentes à éviter
- Travailler à la maille du siège social. Le score reflète alors l'adresse administrative, pas les sites qui portent le risque.
- Mélanger des périodes sans le dire. Une couche de 2018 et une autre de 2025 ne décrivent pas le même état du milieu.
- Remplacer une donnée absente par une valeur moyenne sans la signaler. L'absence d'information est elle-même une information pour le comité.
- Se fier à un modèle sans contrôle. Les sorties statistiques se confrontent aux observations de terrain lorsqu'elles existent, comme le recommande le NGFS.
- Négliger les secteurs peu couverts. Pour l'agriculture, la forêt ou la pêche, où les données sont plus lacunaires selon le CGFI, prévoir des hypothèses explicites et une vérification complémentaire.
Questions fréquentes
Où trouver des données environnementales publiques en France ?
Le point d'entrée principal est data.gouv.fr, complété par le catalogue ecologie.data.gouv.fr pour les données du pôle ministériel et par cartes.gouv.fr pour la recherche cartographique par thème, producteur, date ou territoire. L'inventaire de l'Ineris recense par ailleurs des bases nationales thématiques comme Basias, Basol ou Ades.
Pourquoi croiser plusieurs bases plutôt qu'en utiliser une seule ?
Chaque base a ses lacunes temporelles ou spatiales : couverture partielle, mise à jour ancienne, résolution trop large. Le croisement permet de les compenser et de recouper les informations. Il impose en contrepartie un travail d'harmonisation et de validation, notamment par des observations de terrain.
Quelle précision de géolocalisation faut-il viser ?
Celle du site opérationnel, et non du siège. Les coordonnées GPS sont les plus fiables, tandis que des adresses géocodées manuellement peuvent être imprécises et désaligner le site d'une carte de risques. Il est recommandé d'associer à chaque coordonnée une source et un niveau de confiance.
Le croisement par intelligence artificielle est-il fiable ?
Il l'est lorsqu'il s'appuie sur des sources traçables, une méthodologie documentée et une validation par des experts. Le NGFS rappelle que l'apprentissage automatique peut omettre des complexités physiques et conduire à des évaluations trompeuses si les données sont de faible qualité. La traçabilité de chaque étape est donc indispensable.
Sources
- NGFS, Navigating nature-related data: metrics, sources and uses (avril 2026)
- Société Générale, Understanding nature impacts across financed activities
- Documentation ecologie.data.gouv.fr, Sélection des données
- Ineris, Inventaire des bases de données environnementales
- Guides data.gouv.fr, Trouver des données
- cartes.gouv.fr, Rechercher une donnée
- CGFI, Asset location data sources for nature-related financial risk analysis (2024)
- Natixis CIB, Connecting the dots: geospatial data for sustainable finance